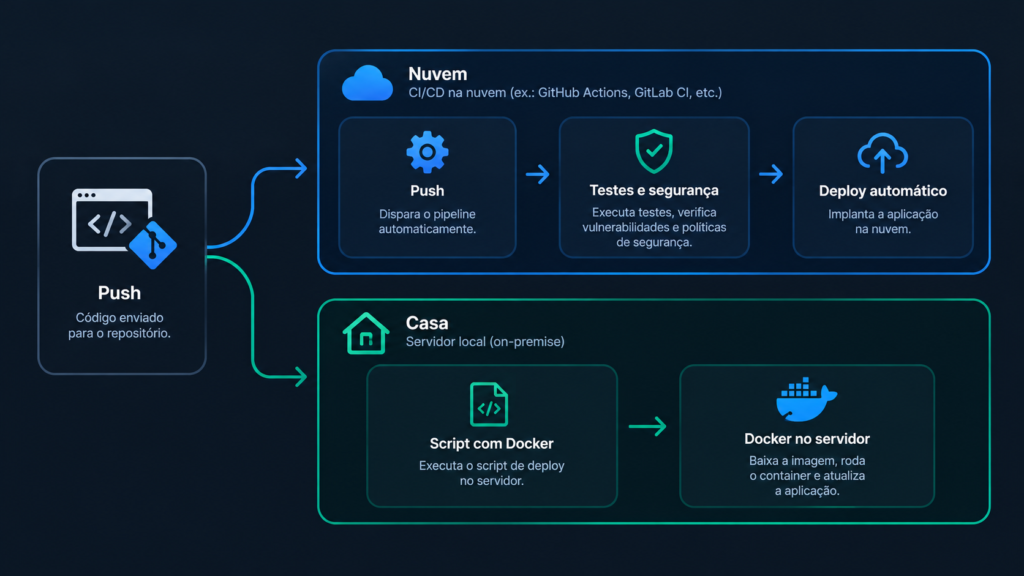
Quando você trabalha em equipe, alguém cuida da infraestrutura. Em um deploy de dev solo, essa pessoa é você, e o tempo gasto com publicação sai direto do tempo que você teria para construir o produto. Por isso, tento deixar o deploy o mais chato e previsível possível.
Neste post, explico como funciona o meu processo: CI/CD para os projetos na nuvem e um script com Docker para os que rodam em casa. Também conto os erros que me custaram tempo, para você não repetir.
Fluxo de deploy de dev solo com CI/CD na nuvem e script com Docker em casa
O que muda no deploy de dev solo
Em uma empresa, o deploy costuma ter etapas, aprovações e várias pessoas envolvidas. No meu caso, nada disso existe. Em compensação, também não há ninguém para me avisar quando eu esquecer um passo.
Assim, o critério mais importante é simples: o deploy não pode depender da minha memória. Se eu preciso lembrar uma sequência de comandos para publicar, cedo ou tarde vou esquecer algum. Portanto, tudo que se repete vira automação.
Onde cada projeto roda no meu deploy de dev solo
Meus projetos não ficam todos no mesmo lugar. A regra é objetiva: o que precisa de acesso à rede local fica no servidor em casa, e o resto vai para a nuvem.
Na nuvem, a arquitetura de um dos meus produtos tem três peças publicadas de forma independente:
- a API em Python (FastAPI), em um serviço gerenciado de PaaS;
- o frontend em Angular, servido como site estático no mesmo PaaS;
- o site institucional, estático, em uma hospedagem tradicional com Apache.
Por trás da API, há um Postgres gerenciado, um storage compatível com S3 e um Redis para limitar requisições. Ter peças independentes permite publicar cada uma sem mexer nas outras.
CI/CD no deploy de dev solo: o CI como portão
Cada repositório tem um workflow no GitHub Actions que roda em todo push na main. Na API, são dois jobs. O primeiro roda os testes com pytest contra um Postgres efêmero, criado pelo próprio job. O segundo cuida da segurança, com pip-audit para as dependências e bandit para análise estática.
No frontend, um job faz o build de produção e outro roda npm audit --omit=dev. Esse comando olha só as dependências que chegam ao navegador. Vulnerabilidades em ferramentas de desenvolvimento ficam com o Dependabot. Assim, o CI não fica vermelho o tempo todo por algo que nem vai para produção.
O PaaS só publica depois que os checks passam, e não a cada commit. Há um detalhe que pega: se o commit não tiver nenhum check associado, o deploy simplesmente não acontece. Por isso, antes de ligar essa opção, confirme que o workflow já rodou pelo menos uma vez.
Se você quer organizar a configuração de cada ambiente, o guia The Twelve-Factor App é uma leitura clássica.
Migrations automáticas: o erro que quebrou meu deploy de dev solo
As migrations do Alembic rodam encadeadas no comando de start, algo como alembic upgrade head && uvicorn .... Dessa forma, não existe passo manual para esquecer.
A parte interessante é o privilégio. A aplicação conecta ao banco com um role restrito, que só pode fazer SELECT, INSERT, UPDATE e DELETE. Ela não cria nem altera tabelas. Isso protege bastante, mas quebra as migrations, que precisam alterar a estrutura do banco.
A solução foi dar ao Alembic uma URL de conexão separada, com o role dono das tabelas, usada só durante a migração. O runtime nunca recebe esse privilégio.
Descobri isso do jeito difícil. Uma migration com ALTER TABLE passou porque rodou antes da troca de role. A migration seguinte, no entanto, quebrou o deploy com InsufficientPrivilegeError. A lição é que o teste só vale se rodar com as mesmas permissões de produção.
Três pegadinhas de PaaS que custam tempo
Alguns problemas só aparecem depois que você publica. Estes foram os que mais me custaram:
- O Start Command do painel sobrepõe o Procfile. Se o painel guardar um comando antigo, sem as migrations, o deploy aparece verde e a aplicação sobe. Só que as rotas que dependem de colunas novas devolvem erro 500. Se uma rota nova quebra com “coluna inexistente”, olhe esse campo primeiro.
- Fixe a versão do Python. O runtime padrão do PaaS era mais novo e tinha um OpenSSL mais rígido, que rejeitou o certificado de CA do banco gerenciado. Um arquivo
.python-versionresolveu. - SPA precisa de rewrite. No site estático, uma regra
/*→/index.htmlfaz as rotas do Angular funcionarem em links diretos e no refresh da página.
O site institucional: deploy de dev solo à moda antiga
Nem tudo precisa de pipeline. O site institucional é publicado do jeito antigo: faço o build do Tailwind localmente e envio por FTP. Os headers de segurança, incluindo a CSP, ficam em um .htaccess.
Uma CSP restritiva, com font-src 'self', bloqueia sem aviso fontes carregadas de CDN externa. Por isso, passei a servir as fontes do próprio domínio.
Deploy de dev solo em casa: um script com Docker
Nos projetos que rodam em casa, não uso CI/CD nem registry de imagens. O deploy cabe em um único script de shell.
Como a stack é montada
Meu servidor doméstico roda os projetos em Docker. O front-end é uma SPA em Angular que conversa com alguns serviços de back-end independentes. Cada serviço tem o seu container e o seu banco SQLite, guardado em um volume.
Um docker-compose.yml sobe a stack inteira, e todos os containers usam network_mode: host. Assim, os serviços se falam por localhost, sem redes Docker customizadas, cada um em uma porta fixa.
O front-end é servido por um nginx, que também funciona como proxy reverso. Cada prefixo /api/<serviço>/ é encaminhado para a porta do serviço certo, sem o prefixo. Para o navegador, existe uma única origem. Com isso, o CORS desaparece e o cookie httpOnly de refresh funciona sem configuração extra.
O build e o script de deploy
O Dockerfile tem dois estágios. No primeiro, uma imagem Node instala as dependências com npm ci e gera o build de produção. No segundo, uma imagem nginx:alpine recebe só os arquivos estáticos e o nginx.conf. Dessa forma, a imagem final fica pequena e sem Node.
O script deploy.sh faz tudo por SSH, em três passos:
- Envia o
docker-compose.ymlversionado no repositório para o servidor. - Envia o código do
HEADcomgit archive. Só vai o que está commitado, então alterações locais soltas nunca sobem por engano. - Roda
docker compose up -d --build webno servidor. O build acontece lá, e só o container do front-end é recriado. Os back-ends continuam no ar.
O endereço do servidor e o diretório remoto vêm de variáveis de ambiente, com valores padrão no script.
Por que gosto desse formato
Para projetos de uso pessoal, uma pipeline completa daria mais trabalho de manter do que o problema que ela resolve. Por isso, essa abordagem simples funciona melhor para mim:
- Não depende de nenhum serviço externo.
- Um comando faz o deploy:
./scripts/deploy.sh. - O que roda no servidor é sempre um commit do Git.
- Para voltar uma versão, basta fazer checkout do commit anterior e rodar o script de novo.
- O compose versionado descreve a stack inteira e serve como documentação.
O que nunca fica no código
Existe um cuidado que vale para qualquer ambiente: segredos não entram no repositório. Senhas, chaves de API e tokens ficam em arquivos .env fora do controle de versão, criados manualmente em cada ambiente. O repositório guarda só um .env.example, com placeholders.
Antes de escrever este post, revisei os repositórios para confirmar isso. Nenhum .env foi versionado, nem no histórico, e os .env.example têm apenas valores de exemplo ou campos vazios. Também procurei no histórico por padrões de chaves de API, webhooks, JWTs e URLs de banco com senha, e não encontrei nenhum segredo real.
Em casa, o processo é bem simples. Os arquivos .env ficam em cada diretório de serviço no servidor, ao lado do compose, e o docker-compose.yml os injeta nos containers. O script de deploy não os envia. Eu os crio uma vez, à mão, e depois só mantenho. O .env.example do serviço de autenticação, aliás, pede para gerar um par de chaves separado para cada ambiente. Assim, as chaves de um ambiente não servem em outro.
Isso não é um cofre de segredos, e vale deixar claro para ninguém imaginar algo mais sofisticado. Ainda assim, resolve o essencial: o mesmo código roda em qualquer lugar, e um vazamento do repositório não expõe nenhuma credencial. Além disso, trocar uma chave vira só uma alteração de configuração, sem novo commit.
Na nuvem, o princípio é o mesmo, mas a ferramenta muda. As variáveis de produção ficam no painel do PaaS. O desenvolvimento usa um .env local, e o CI usa valores próprios. O .gitignore também cobre certificados (*.pem), então o certificado do banco nunca vai para o Git. No frontend, os arquivos de ambiente guardam só a URL da API e um campo de monitoramento vazio, que são dados públicos por natureza.
Como reduzo o risco no deploy de dev solo
Sem equipe para revisar, preciso de proteções automáticas. Hoje tenho duas em funcionamento, e outras duas estão nos próximos passos. Primeiro, o que já funciona:
- Testes e análise de segurança antes da publicação na nuvem. Na pipeline, são a primeira barreira.
- Capacidade de voltar atrás. Na nuvem, o código pode ser revertido para qualquer deploy anterior com um clique. Em casa, basta fazer checkout do commit anterior e rodar o script de novo. Isso reverte o código, mas não desfaz migrations já aplicadas no banco.
Agora, o que ainda falta:
- Backup automatizado. Uma migration com problema é o pior tipo de erro, porque os dados não voltam sozinhos. Por isso, este é o próximo passo da minha lista.
- Alertas quando algo quebra. Prefiro receber um aviso a descobrir o problema por um usuário. Também está nos próximos passos.
Para quem está começando, não é preciso montar tudo de uma vez. Comece pelos testes automáticos e pela possibilidade de voltar atrás. Depois, adicione backup e alertas conforme os projetos crescem. É o caminho que estou seguindo. As decisões de arquitetura por trás dessas escolhas estão no post FastAPI x Angular.
Deploy de dev solo: simples vale mais que sofisticado
No fim das contas, o melhor deploy de dev solo não é o mais moderno, e sim o que você consegue manter sozinho sem esforço. Cada ferramenta nova é mais uma coisa para atualizar, entender e consertar quando quebrar.
Por isso, prefiro poucas peças, bem conhecidas, funcionando sempre do mesmo jeito. O tempo que sobra vai para o que importa: construir o produto.
E você, como publica seus projetos hoje? Conta nos comentários o que mais te dá trabalho no deploy.
0 Comentários